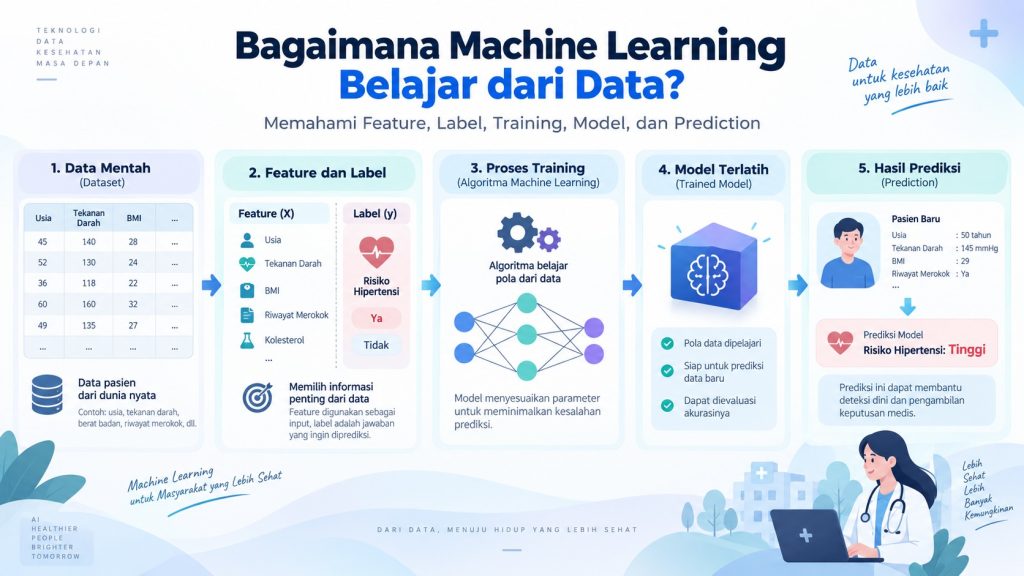
Memahami Feature, Label, Training, Model, dan Prediction
Pada artikel sebelumnya kita telah membahas hubungan antara Artificial Intelligence (AI), Machine Learning (ML), Deep Learning, dan Generative AI. Pertanyaan berikutnya adalah: sebenarnya bagaimana sebuah mesin dapat “belajar” dari data?
Ketika dikatakan bahwa Machine Learning dapat belajar, komputer tentu tidak belajar seperti manusia. Komputer tidak memahami penyakit, perilaku manusia, atau kesehatan dalam pengertian sebagaimana seorang epidemiolog atau tenaga kesehatan memahaminya.
Yang dilakukan Machine Learning adalah mengidentifikasi pola matematis dari data berdasarkan suatu algoritma, kemudian menggunakan pola tersebut untuk menghasilkan prediksi terhadap data baru.
Jordan dan Mitchell mendeskripsikan Machine Learning sebagai bidang yang mempelajari bagaimana membangun sistem komputer yang dapat meningkatkan kinerjanya melalui pengalaman. Bidang ini berada pada persimpangan ilmu komputer dan statistik serta menjadi salah satu fondasi utama perkembangan Artificial Intelligence modern [1].
Untuk memahami proses tersebut, kita perlu mengenal beberapa istilah dasar: observation, feature, target atau label, algorithm, training, model, testing, prediction, dan generalization.
Dari Data Menuju Prediction
Secara sederhana, proses Machine Learning dapat digambarkan sebagai:
Data → Features + Target → Algorithm → Training → Model → Testing → Prediction
Setiap komponen memiliki fungsi yang berbeda.
Bayangkan kita memiliki data 10.000 orang dewasa dan ingin mengembangkan model untuk memprediksi hipertensi.
Data yang tersedia antara lain:
- umur,
- jenis kelamin,
- indeks massa tubuh,
- lingkar pinggang,
- aktivitas fisik,
- status merokok,
- denyut nadi,
- riwayat penyakit, dan
- status hipertensi.
Dari data tersebut komputer mencoba mempelajari pola:
Karakteristik seperti apa yang sering ditemukan pada seseorang dengan hipertensi?
Setelah pola tersebut dipelajari, model dapat menerima data seseorang yang belum pernah dilihat sebelumnya dan menghasilkan suatu prediksi.
Misalnya:
Probability of hypertension = 0,82
Artinya, berdasarkan pola yang telah dipelajari model, individu tersebut memiliki probabilitas yang diprediksi sebesar 82% untuk termasuk ke dalam kategori hipertensi, sesuai definisi outcome dan konteks model yang digunakan.
Bagaimana komputer sampai pada angka tersebut?
Mari kita lihat tahapannya.
Sebuah dataset terdiri atas sejumlah observations atau unit pengamatan.
Dalam penelitian kesehatan masyarakat, satu observation dapat berupa:
- seorang individu,
- seorang pasien,
- satu rumah tangga,
- satu kunjungan pelayanan kesehatan,
- satu desa,
- satu kabupaten/kota,
- atau satu periode waktu.
Misalnya dataset hipertensi memiliki 10.000 individu.
Secara sederhana:
| ID | Umur | IMT | Merokok | Aktivitas Fisik | Hipertensi |
|---|---|---|---|---|---|
| 001 | 28 | 22,1 | Tidak | Cukup | Tidak |
| 002 | 57 | 30,2 | Ya | Kurang | Ya |
| 003 | 46 | 27,8 | Tidak | Kurang | Ya |
| 004 | 32 | 23,4 | Ya | Cukup | Tidak |
Setiap baris merepresentasikan satu observation.
Sementara itu, kolom-kolom berisi berbagai karakteristik yang dimiliki observation tersebut.
2. Features: Informasi yang Digunakan Model untuk Belajar
Dalam Machine Learning, variabel yang digunakan untuk membantu membuat prediksi sering disebut features.
Dalam statistik atau epidemiologi, konsep ini dekat dengan istilah:
- independent variables,
- predictors,
- explanatory variables,
- covariates.
Sebagai contoh, untuk memprediksi hipertensi kita dapat menggunakan:
Features:
- umur,
- jenis kelamin,
- IMT,
- lingkar pinggang,
- merokok,
- aktivitas fisik,
- denyut nadi.
Biasanya dinotasikan sebagai:
X
atau secara lebih lengkap:
X₁, X₂, X₃, …, Xₚ
Pemilihan feature merupakan bagian penting dalam pengembangan model.
Lebih banyak feature tidak selalu berarti model menjadi lebih baik. Feature yang tidak relevan, kualitasnya buruk, mengandung banyak missing value, atau membawa informasi yang seharusnya belum tersedia pada waktu prediksi justru dapat menghasilkan model yang buruk atau menyesatkan.
Karena itu, pengetahuan mengenai substansi kesehatan tetap sangat penting dalam pengembangan Machine Learning.
3. Label atau Target: Apa yang Ingin Diprediksi?
Jika feature merupakan informasi yang digunakan untuk membuat prediksi, maka target adalah sesuatu yang ingin diprediksi.
Istilah lain yang sering digunakan adalah:
- label,
- outcome,
- response variable,
- dependent variable.
Dalam contoh kita:
Target = status hipertensi
misalnya:
0 = tidak hipertensi
1 = hipertensi
Variabel target sering dilambangkan dengan:
y
Sehingga secara konseptual Machine Learning mencoba mempelajari suatu fungsi:
X → y
atau:
Berdasarkan sekumpulan features X, bagaimana kita dapat memperkirakan outcome y?
Jika target berupa kategori, seperti:
Hipertensi / Tidak Hipertensi
masalah tersebut disebut classification.
Jika target berupa angka kontinu, misalnya:
tekanan darah sistolik = 137 mmHg
maka masalah tersebut biasanya disebut regression.
4. Algorithm: Cara Komputer Belajar
Setelah memiliki features dan target, kita membutuhkan suatu prosedur matematis agar komputer dapat mempelajari hubungan di antara keduanya.
Prosedur tersebut disebut algorithm.
Contohnya:
- Logistic Regression,
- Decision Tree,
- Random Forest,
- Support Vector Machine,
- k-Nearest Neighbors,
- Naive Bayes,
- Neural Network.
Setiap algoritma mempunyai cara berbeda dalam menemukan pola.
Logistic Regression, misalnya, memodelkan hubungan antara sejumlah predictor dengan probabilitas suatu outcome.
Decision Tree membuat serangkaian pemisahan berdasarkan karakteristik data.
Random Forest membangun banyak decision trees dan menggabungkan hasilnya.
Neural Network mempelajari representasi melalui jaringan unit komputasi yang tersusun dalam sejumlah lapisan.
Hastie, Tibshirani, dan Friedman membahas berbagai keluarga metode tersebut dalam The Elements of Statistical Learning, salah satu referensi fundamental di bidang statistical learning [2].
Namun terdapat satu perbedaan terminologi yang penting:
Algorithm bukanlah model.
Algorithm adalah cara atau prosedur belajar.
Model merupakan hasil yang diperoleh setelah algorithm belajar dari data.
5. Training: Proses Model Belajar
Proses ketika algoritma mempelajari pola dari data disebut training.
Data yang digunakan dalam proses tersebut disebut:
training data atau training set.
Misalnya dari 10.000 data individu, 7.000 digunakan untuk training.
Algoritma kemudian mencoba menemukan parameter atau pola yang menghasilkan prediksi paling baik berdasarkan data tersebut.
Pada logistic regression, misalnya, training akan menghasilkan koefisien untuk setiap predictor.
Secara sederhana kita dapat memperoleh pola seperti:
Risiko Hipertensi = f(Umur, IMT, Lingkar Pinggang, Aktivitas Fisik, …)
Komputer akan menyesuaikan parameter model sehingga perbedaan antara hasil prediksi dengan nilai sebenarnya dapat diminimalkan menurut fungsi objektif yang digunakan.
Proses inilah yang sering disebut:
model fitting atau learning.
6. Loss Function: Bagaimana Komputer Mengetahui Bahwa Prediksinya Salah?
Agar dapat belajar, algoritma membutuhkan suatu ukuran untuk mengetahui seberapa buruk prediksinya.
Ukuran tersebut disebut loss function.
Bayangkan model memprediksi:
Probability hipertensi = 0,90
tetapi individu tersebut ternyata tidak hipertensi.
Model telah melakukan kesalahan.
Loss function memberikan nilai matematis terhadap kesalahan tersebut.
Selama training, algoritma berusaha:
meminimalkan loss
sehingga secara konseptual:
Prediction → Compare with Actual Outcome → Calculate Loss → Adjust Model → Repeat
Proses tersebut dapat dilakukan berulang kali hingga diperoleh parameter model yang dianggap optimal berdasarkan kriteria yang digunakan.
Inilah salah satu mekanisme utama bagaimana sebuah sistem Machine Learning “belajar”.
7. Model: Hasil dari Proses Belajar
Setelah proses training selesai, kita memperoleh sebuah trained model.
Model merupakan representasi matematis dari pola yang ditemukan dalam training data.
Secara konseptual:
Training Data + Algorithm → Trained Model
Model inilah yang nantinya digunakan untuk menghadapi data yang belum pernah dilihat sebelumnya.
Contohnya:
Pasien baru
Umur = 58 tahun
IMT = 31 kg/m²
Aktivitas fisik = kurang
Merokok = ya
Denyut nadi = 86 kali/menit
Data tersebut diberikan kepada model:
New Data → Trained Model → Prediction
Misalnya model menghasilkan:
Predicted probability = 0,78
8. Prediction: Menggunakan Model pada Data Baru
Tujuan utama banyak aplikasi Machine Learning adalah menghasilkan prediksi yang baik pada data baru.
Ini merupakan konsep yang sangat penting.
Model tidak dikembangkan sekadar agar mampu menjelaskan data yang sudah dimilikinya.
Model diharapkan dapat bekerja pada observation yang tidak digunakan untuk membangun model.
Misalnya:
Input
Umur = 60
IMT = 29
Aktivitas fisik = kurang
Merokok = ya
↓
Machine Learning Model
↓
Output
Probability of hypertension = 0,82
Jika kita menetapkan threshold 0,50, maka:
0,82 ≥ 0,50 → Predicted: Hypertension
Namun perlu diperhatikan bahwa nilai threshold tidak selalu harus 0,50. Pemilihan threshold tergantung tujuan penggunaan model serta konsekuensi dari false positive dan false negative.
Dalam konteks skrining kesehatan, misalnya, kita mungkin lebih mengutamakan sensitivitas sehingga threshold yang digunakan dapat berbeda.
9. Mengapa Data Harus Dibagi Menjadi Training dan Testing?
Di sinilah terdapat salah satu prinsip paling fundamental dalam Machine Learning.
Jika kita membangun model dan mengevaluasi model menggunakan data yang sama, hasilnya dapat terlihat sangat baik karena model sudah pernah “melihat” data tersebut.
Karena itu dataset biasanya dibagi menjadi:
Training Data
digunakan untuk membangun model.
dan
Testing Data
digunakan untuk mengevaluasi kemampuan model pada data yang sebelumnya tidak digunakan dalam training.
Sebagai contoh:
10.000 observations
↓
80% Training Data = 8.000
20% Testing Data = 2.000
Model dibangun menggunakan 8.000 observation.
Setelah selesai, 2.000 observation yang tersisa diberikan kepada model untuk mengetahui seberapa baik model melakukan prediksi.
Buku The Elements of Statistical Learning menempatkan model assessment dan model selection sebagai komponen penting dalam statistical learning [2].
10. Validation Data: Lapisan Evaluasi Tambahan
Dalam banyak pengembangan Machine Learning, data bahkan dibagi menjadi tiga:
Training Set → Validation Set → Test Set
Training set
Untuk mempelajari parameter model.
Validation set
Untuk memilih model atau melakukan hyperparameter tuning.
Test set
Untuk melakukan evaluasi akhir terhadap model yang sudah ditentukan.
Secara konseptual:
Training → Build
Validation → Tune and Select
Testing → Final Evaluation
Pendekatan lain yang sangat umum adalah cross-validation, di mana data training dibagi secara bergantian menjadi bagian training dan validation.
Topik ini penting karena model yang terlihat sangat baik pada satu dataset belum tentu dapat memberikan performa yang sama ketika diterapkan pada populasi lain.
11. Overfitting: Ketika Model Menghafal Data
Salah satu masalah terbesar dalam Machine Learning adalah overfitting.
Overfitting terjadi ketika model belajar terlalu spesifik terhadap training data.
Model bahkan dapat mempelajari noise atau karakteristik kebetulan yang hanya terdapat pada dataset tersebut.
Akibatnya:
Performance pada Training Data → Sangat baik
tetapi:
Performance pada New Data → Buruk
Bayangkan seorang mahasiswa yang bukan memahami konsep, tetapi menghafalkan seluruh jawaban latihan.
Ketika soal ujian persis sama, ia memperoleh nilai sempurna.
Namun ketika pertanyaannya sedikit berbeda, ia kesulitan menjawab.
Model Machine Learning dapat mengalami masalah serupa.
Oleh karena itu, tujuan pengembangan Machine Learning bukan:
membuat model yang paling bagus terhadap training data.
Tetapi:
membuat model yang mampu memberikan prediksi yang baik terhadap data baru yang relevan dengan tujuan penggunaannya.
12. Generalization: Tujuan Sebenarnya Machine Learning
Kemampuan sebuah model untuk bekerja dengan baik pada data yang sebelumnya tidak pernah dilihat disebut generalization.
Ini merupakan salah satu konsep paling penting dalam Machine Learning.
Model yang baik tidak hanya harus:
fit terhadap training data
tetapi juga:
generalize terhadap new data.
Dalam konteks kesehatan masyarakat, persoalan generalization menjadi semakin penting.
Model hipertensi yang dikembangkan dari populasi tertentu belum tentu secara otomatis memiliki performa yang sama ketika diterapkan pada:
- kelompok umur berbeda,
- wilayah berbeda,
- kelompok etnis berbeda,
- periode waktu berbeda,
- atau sistem pelayanan kesehatan berbeda.
Karena itu, external validation menjadi sangat penting sebelum suatu model prediksi digunakan lebih luas dalam praktik kesehatan.
13. Data Leakage: Ketika Model Mendapatkan Jawaban Sebelum Ujian
Masalah lain yang perlu dikenali sejak awal adalah data leakage.
Data leakage terjadi ketika informasi yang seharusnya tidak tersedia pada saat prediction secara tidak sengaja masuk ke dalam proses training.
Misalnya kita ingin memprediksi apakah pasien akan dirawat di ICU.
Tetapi salah satu feature yang digunakan adalah:
jenis terapi yang baru diberikan setelah pasien masuk ICU.
Model dapat terlihat sangat akurat.
Namun model sebenarnya memperoleh informasi tentang outcome dari “masa depan”.
Ini mirip memberikan kunci jawaban kepada mahasiswa sebelum ujian.
Performance model menjadi sangat tinggi, tetapi tidak merepresentasikan kemampuan prediction yang sebenarnya.
14. Apakah Prediction Sama dengan Causation?
Ini juga merupakan aspek yang sangat penting, terutama bagi epidemiolog dan peneliti kesehatan masyarakat.
Machine Learning dapat menemukan pola yang berguna untuk prediction.
Namun:
kemampuan memprediksi tidak otomatis membuktikan hubungan sebab-akibat.
Misalnya sebuah feature sangat kuat dalam memprediksi penyakit.
Hal tersebut tidak otomatis berarti bahwa mengubah feature tersebut akan menyebabkan risiko penyakit berubah sebesar prediksi model.
Pertanyaan:
“Siapa yang kemungkinan mengalami hipertensi?”
merupakan prediction problem.
Sedangkan:
“Apakah peningkatan IMT menyebabkan meningkatnya risiko hipertensi?”
merupakan causal question.
Keduanya merupakan pertanyaan ilmiah yang berbeda dan membutuhkan kerangka metodologi yang berbeda.
15. Contoh Lengkap: Prediksi Hipertensi
Sekarang seluruh proses dapat kita susun kembali.
Langkah 1 — Tentukan masalah
Kita ingin mengidentifikasi individu dengan risiko hipertensi.
Langkah 2 — Kumpulkan data
Misalnya tersedia 20.000 individu.
Langkah 3 — Tentukan features
Umur
Jenis kelamin
IMT
Lingkar pinggang
Merokok
Aktivitas fisik
Denyut nadi
Langkah 4 — Tentukan target
0 = tidak hipertensi; 1 = hipertensi
Langkah 5 — Pisahkan dataset
Training Data → 80% ; Testing Data → 20%
Langkah 6 — Pilih algorithm
Misalnya:
Logistic Regression
Langkah 7 — Training
Algorithm mempelajari pola hubungan features dengan status hipertensi.
Langkah 8 — Diperoleh model
Model kemudian mampu menghasilkan probabilitas hipertensi.
Langkah 9 — Testing
Model diberikan data yang tidak digunakan dalam training.
Langkah 10 — Evaluation
Performance dievaluasi menggunakan ukuran seperti:
- sensitivity,
- specificity,
- precision,
- recall,
- F1-score,
- ROC curve,
- AUC,
- dan calibration.
Langkah 11 — Prediction
Model kemudian dapat digunakan untuk memperkirakan risiko pada observation baru, setelah melalui validasi yang memadai dan sesuai dengan konteks penggunaan.
Dari Dataset Menjadi Knowledge?
Di sinilah terdapat satu hal yang sering disalahpahami.
Machine Learning tidak secara otomatis mengubah data menjadi “kebenaran”.
Secara sederhana prosesnya adalah:
Real World –> Data Collection –> Dataset –> Feature Engineering –> Algorithm –> Training –> Model –> Prediction –> Human Interpretation –> Decision
Setiap tahap mempunyai potensi masalah. Jika data yang dikumpulkan bias, maka model dapat belajar dari bias tersebut. Jika outcome didefinisikan secara keliru, model akan belajar berdasarkan definisi yang keliru. Jika sampel tidak mewakili populasi target, performa model pada populasi sebenarnya dapat menurun. Karena itu kualitas Machine Learning sangat bergantung pada kualitas data dan desain pengembangannya.
Prinsip klasik dalam komputasi masih tetap relevan:
Garbage In → Garbage Out
Model yang sangat kompleks tidak dapat memperbaiki secara ajaib data yang secara fundamental buruk.
Machine Learning Tetap Membutuhkan Manusia
Perkembangan Machine Learning terkadang menimbulkan kesan bahwa komputer dapat menemukan seluruh jawaban sendiri dari data.
Pada kenyataannya, manusia tetap mempunyai peran yang sangat besar.
Manusia menentukan:
- pertanyaan apa yang penting,
- data apa yang relevan,
- outcome apa yang ingin diprediksi,
- bagaimana data dikumpulkan,
- bagaimana model dievaluasi, dan yang paling penting:
- bagaimana hasil prediction digunakan untuk mengambil keputusan.
Dalam kesehatan, Rajkomar, Dean, dan Kohane menunjukkan besarnya potensi Machine Learning untuk menggunakan data kesehatan dalam mendukung prediction dan pengambilan keputusan [3]. Sidey-Gibbons dan Sidey-Gibbons juga menekankan bahwa penggunaan Machine Learning dalam penelitian kesehatan perlu disertai pemahaman mengenai preprocessing, pemilihan algoritma, training, validation, serta evaluasi model [4].
Dengan demikian, Machine Learning bukan sekadar tentang komputer.
Ia merupakan kombinasi antara:
Data + Mathematics + Computer Science + Domain Knowledge + Human Judgment.
Dalam kesehatan masyarakat, komponen terakhir sangat penting karena model pada akhirnya digunakan dalam konteks manusia, populasi, kebijakan, dan pelayanan kesehatan.
Kesimpulan
Konsep dasar Machine Learning sebenarnya dapat diringkas dalam satu alur:
Data → Learning → Model → Prediction
Namun di balik alur sederhana tersebut terdapat beberapa konsep penting:
Observation adalah unit yang kita pelajari.
Features adalah informasi yang digunakan untuk prediction.
Target atau label adalah outcome yang ingin diprediksi.
Algorithm adalah prosedur yang digunakan komputer untuk belajar.
Training adalah proses mempelajari pola dari data.
Model adalah hasil dari proses training.
Testing digunakan untuk mengetahui kemampuan model terhadap data yang belum pernah dilihat.
Prediction merupakan output model terhadap data baru.
Dan generalization adalah kemampuan model tetap memberikan performa yang baik ketika menghadapi data di luar training set.
Karena itu, keberhasilan sebuah Machine Learning model bukan ditentukan oleh seberapa baik ia menghafal data yang sudah ada.
Ukuran yang lebih penting adalah:
Seberapa baik model tersebut dapat memberikan prediksi yang valid, dapat dipercaya, dan bermanfaat ketika menghadapi data baru di dunia nyata?
Referensi
- Jordan MI, Mitchell TM. Machine learning: Trends, perspectives, and prospects. Science. 2015;349(6245):255–260. doi:10.1126/science.aaa8415.
- Hastie T, Tibshirani R, Friedman J. The Elements of Statistical Learning: Data Mining, Inference, and Prediction. 2nd ed. New York: Springer; 2009. doi:10.1007/978-0-387-84858-7.
- Rajkomar A, Dean J, Kohane I. Machine Learning in Medicine. New England Journal of Medicine. 2019;380(14):1347–1358. doi:10.1056/NEJMra1814259.
- Sidey-Gibbons JAM, Sidey-Gibbons CJ. Machine learning in medicine: a practical introduction. BMC Medical Research Methodology. 2019;19:64. doi:10.1186/s12874-019-0681-4.
- James G, Witten D, Hastie T, Tibshirani R. An Introduction to Statistical Learning: with Applications in R. 2nd ed. New York: Springer; 2021. doi:10.1007/978-1-0716-1418-1.