Dua Dunia yang Berbeda, atau Sebenarnya Saling Beririsan?
Bagi seseorang yang berasal dari epidemiologi, biostatistik, atau kesehatan masyarakat, ketika pertama kali belajar Machine Learning mungkin muncul pertanyaan:
Apa sebenarnya yang berbeda? Bukankah kita selama ini juga menggunakan data untuk membuat model?
Dalam statistik kita mengenal:
- regresi linear,
- regresi logistik,
- analisis survival,
- klasifikasi,
- estimasi parameter,
- hingga berbagai model multivariat.
Di Machine Learning kita kembali menemukan istilah:
- regression,
- classification,
- prediction,
- features,
- model,
- training,
- testing.
Bahkan salah satu metode yang paling sering digunakan dalam Machine Learning adalah Logistic Regression, metode yang juga sangat familiar dalam epidemiologi.
Jadi, apakah Machine Learning sebenarnya hanya statistik dengan nama baru?
Jawabannya:
Tidak sesederhana itu.
Statistik dan Machine Learning mempunyai sejarah, tradisi, tujuan, dan pendekatan evaluasi yang berbeda. Namun batas antara keduanya semakin kabur.
Cara paling tepat untuk memahami perbedaannya bukan dengan bertanya:
“Metode ini statistik atau Machine Learning?”
tetapi:
“Untuk tujuan apa model ini dibangun?”
Statistik dan Machine Learning Berangkat dari Data yang Sama
Bayangkan kita memiliki dataset 20.000 orang dewasa.
Variabel yang tersedia adalah:
- umur,
- jenis kelamin,
- pendidikan,
- IMT,
- lingkar pinggang,
- merokok,
- aktivitas fisik,
- denyut nadi,
- dan status hipertensi.
Seorang epidemiolog mungkin bertanya:
Apakah IMT berhubungan dengan kejadian hipertensi setelah dikontrol oleh umur, jenis kelamin, merokok, dan aktivitas fisik?
Sementara seorang data scientist mungkin bertanya:
Seberapa akurat karakteristik tersebut dapat digunakan untuk memprediksi apakah seseorang mengalami hipertensi?
Datanya sama.
Regresi logistik yang digunakan bahkan dapat sama.
Namun tujuan analisisnya berbeda.
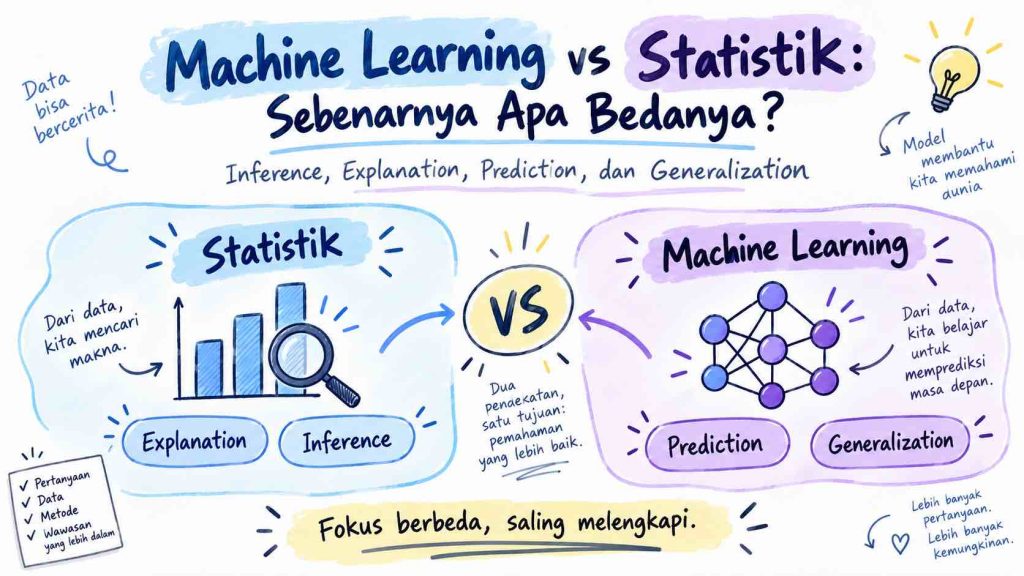
Yang pertama berorientasi pada inference atau explanation.
Yang kedua berorientasi pada prediction.
Perbedaan antara explanatory modeling dan predictive modeling ini merupakan salah satu konsep penting yang dijelaskan oleh Galit Shmueli. Ia menekankan bahwa kemampuan sebuah model untuk menjelaskan hubungan tidak otomatis berarti model tersebut memiliki kemampuan prediksi terbaik, dan sebaliknya [2].
1. Statistik Banyak Bertanya: “Apa Hubungannya?”
Dalam penelitian epidemiologi kita sering mempunyai pertanyaan seperti:
Apakah obesitas berhubungan dengan hipertensi?
Apakah merokok meningkatkan risiko penyakit kardiovaskular?
Apakah pendidikan berhubungan dengan penggunaan pelayanan kesehatan?
Fokus utamanya adalah memahami hubungan antara variabel.
Kita kemudian menggunakan model seperti:
Logistic Regression
dan memperoleh hasil:
OR = 1,52
95% CI = 1,31–1,77
p < 0,001
Interpretasinya mungkin:
Individu dengan obesitas memiliki odds hipertensi 1,52 kali dibandingkan individu yang tidak obesitas setelah dikontrol terhadap variabel lain dalam model.
Di sini perhatian kita tertuju pada:
- besar hubungan,
- arah hubungan,
- uncertainty,
- confidence interval,
- statistical significance,
- potential confounding,
- dan interpretasi parameter.
Pertanyaan utamanya adalah:
“Apa yang dapat kita pelajari mengenai hubungan dalam populasi?”
Bzdok, Altman, dan Krzywinski menggambarkan statistik sebagai bidang yang secara tradisional sangat terkait dengan penarikan inferensi mengenai populasi berdasarkan sampel [3].
2. Machine Learning Banyak Bertanya: “Bisakah Kita Memprediksinya?”
Sekarang gunakan dataset yang sama.
Tetapi pertanyaannya kita ubah:
Berdasarkan umur, jenis kelamin, IMT, lingkar pinggang, merokok, aktivitas fisik, dan denyut nadi, bisakah kita memprediksi status hipertensi seseorang yang belum pernah dilihat model sebelumnya?
Fokusnya berubah.
Kita tidak terutama mencari:
p-value IMT
atau:
Odds Ratio merokok.
Kita lebih tertarik pada:
- seberapa baik model membedakan kasus dan bukan kasus,
- seberapa akurat prediksinya,
- sensitivity,
- specificity,
- precision,
- recall,
- AUC,
- calibration,
- serta performa pada data baru.
Pertanyaan utamanya menjadi:
Apakah pola yang dipelajari dari data sebelumnya dapat digunakan untuk membuat prediksi yang baik pada data yang belum pernah dilihat?
Karena itu, salah satu konsep yang sangat penting dalam Machine Learning adalah:
out-of-sample prediction.
Explanation vs Prediction
Perbedaan ini dapat disederhanakan sebagai berikut:
| Aspek | Statistical Inference | Predictive Machine Learning |
|---|---|---|
| Pertanyaan utama | Apa hubungan antara X dan Y? | Bisakah X memprediksi Y? |
| Fokus | Explanation/inference | Prediction/generalization |
| Contoh | Apakah obesitas terkait hipertensi? | Siapa yang kemungkinan hipertensi? |
| Parameter | Sangat penting | Tidak selalu menjadi fokus |
| Confidence interval | Umumnya penting | Bukan fokus utama |
| p-value | Sering digunakan | Biasanya bukan ukuran utama |
| Prediction data baru | Bisa dilakukan | Sangat penting |
| Train/test split | Tidak selalu digunakan dalam analisis inferensial klasik | Fundamental |
| Cross-validation | Tidak selalu | Sangat umum |
| Interpretability | Sering penting | Bergantung tujuan |
| Performance metric | Model fit dan inferensi | Out-of-sample performance |
Tetapi tabel ini adalah penyederhanaan, bukan batas absolut.
Statistik juga digunakan untuk prediction.
Machine Learning juga dapat digunakan untuk memperoleh insight tentang pola data.
Bahkan banyak metode Machine Learning berasal dari statistika.
Karena itu istilah statistical learning sering digunakan untuk menggambarkan wilayah tempat kedua disiplin tersebut bertemu.
Buku The Elements of Statistical Learning karya Hastie, Tibshirani, dan Friedman merupakan salah satu karya fundamental yang secara eksplisit menggabungkan regression, classification, neural networks, support vector machines, trees, boosting, dan berbagai metode lainnya dalam satu kerangka statistical learning [4].
Contoh Menarik: Logistic Regression
Logistic Regression mungkin merupakan contoh terbaik untuk menunjukkan bahwa batas statistik dan Machine Learning tidak ditentukan oleh nama algoritmanya.
Bayangkan kita mempunyai model:
Hipertensi = f(Age, BMI, Smoking, Physical Activity, Pulse)
Model Logistic Regression yang sama dapat digunakan dengan dua orientasi berbeda.
Sebagai Statistical Model
Kita mungkin ingin mengetahui:
Apakah IMT berhubungan dengan hipertensi setelah mengontrol variabel lainnya?
Maka perhatian tertuju pada:
β IMT –> Odds Ratio –> Confidence Interval –> p-value
Kita ingin menginterpretasikan hubungan.
Sebagai Machine Learning Model
Sekarang Logistic Regression digunakan untuk:
memprediksi hipertensi pada individu baru.
Workflow-nya menjadi:
Dataset –> Training Set –> Fit Logistic Regression –> Validation / Cross-validation –> Test Set –> AUC, Sensitivity, Specificity, Calibration –> Prediction
Model matematisnya bisa sama.
Tetapi tujuan dan cara mengevaluasinya berbeda.
Jadi:
Logistic Regression bukan secara eksklusif “metode statistik” ataupun “algoritma Machine Learning”.
Cara penggunaannya menentukan konteksnya.
3. Statistik Memperhatikan Parameter, ML Memperhatikan Generalization
Dalam statistical inference, parameter model mempunyai posisi penting.
Misalnya:
β₁ = efek umur
β₂ = efek IMT
β₃ = efek merokok
Peneliti ingin mengetahui:
- berapa besar β,
- ke arah mana hubungannya,
- seberapa besar uncertainty,
- apakah confidence interval mencakup nilai null.
Machine Learning sering mempunyai prioritas berbeda.
Sebuah Random Forest dapat mempunyai ratusan decision trees.
Gradient Boosting dapat terdiri atas ratusan atau ribuan weak learners.
Neural Network dapat memiliki jutaan bahkan lebih banyak parameter.
Dalam situasi seperti ini, menafsirkan setiap parameter satu per satu bukanlah tujuan utama.
Pertanyaan yang lebih relevan adalah:
Apakah model memberikan prediction yang akurat pada data baru?
Konsep tersebut disebut:
generalization.
4. In-Sample Fit vs Out-of-Sample Performance
Perbedaan penting lainnya adalah bagaimana kita menentukan apakah sebuah model “bagus”.
Dalam pendekatan statistik tradisional kita dapat memperhatikan:
- likelihood,
- R²,
- adjusted R²,
- AIC,
- BIC,
- goodness-of-fit,
- residual,
- confidence interval.
Semua ukuran ini mempunyai fungsi penting.
Namun Machine Learning sangat menekankan satu hal tambahan:
Bagaimana model bekerja pada data yang tidak digunakan untuk membangunnya?
Misalnya:
Training Accuracy = 98%
Kelihatannya sangat baik.
Tetapi ketika diterapkan pada testing data:
Test Accuracy = 68%
Ada masalah.
Model kemungkinan terlalu menyesuaikan diri terhadap training data.
Kondisi ini dikenal sebagai:
overfitting.
Karena itu ML mempunyai workflow yang sangat khas:
Training → Validation → Testing
atau:
Training → Cross-validation → Testing
Hastie, Tibshirani, dan Friedman menempatkan model assessment dan model selection sebagai bagian penting dari statistical learning, dan buku An Introduction to Statistical Learning juga memberikan perhatian besar pada resampling, cross-validation, regularization, dan model selection [4,5].
5. Mengapa Machine Learning Bisa Menggunakan Banyak Variabel?
Dalam epidemiologi klasik kita biasanya berhati-hati ketika jumlah predictor semakin besar.
Ada berbagai pertimbangan:
- sample size,
- degrees of freedom,
- multicollinearity,
- model stability,
- interpretability.
Machine Learning berkembang sangat cepat sebagian karena kebutuhan untuk menangani dataset yang jauh lebih kompleks.
Bayangkan kita memiliki data:
Electronic Health Records
10.000 variabel.
Genomics
100.000 fitur genetik.
Medical Imaging
jutaan pixel.
Wearable Devices
pengukuran setiap detik.
Dalam kondisi seperti ini kita dapat menghadapi situasi:
p ≫ n
yaitu jumlah features jauh lebih banyak daripada jumlah observations.
Metode Machine Learning dan statistical learning modern mengembangkan berbagai mekanisme seperti:
- regularization,
- feature selection,
- dimensionality reduction,
- ensemble learning,
- representation learning.
Buku The Elements of Statistical Learning bahkan secara eksplisit mencakup metode untuk data berdimensi tinggi, regularization, trees, boosting, neural networks, dan support vector machines.
6. Statistik Biasanya Mempunyai Asumsi. Apakah ML Tidak?
Ada anggapan bahwa:
“Statistik mempunyai asumsi, sedangkan Machine Learning bebas asumsi.”
Pernyataan ini tidak tepat.
Semua model mempunyai asumsi dalam arti luas.
Regresi linear misalnya mempunyai struktur model tertentu mengenai hubungan predictor dengan outcome.
Logistic Regression mengasumsikan struktur tertentu pada log-odds.
Decision Tree membuat asumsi mengenai bagaimana feature space dipartisi.
k-Nearest Neighbors bergantung pada definisi jarak dan asumsi bahwa observation yang dekat memiliki outcome yang mirip.
Neural Network mempunyai arsitektur, loss function, regularization, dan banyak keputusan desain lainnya.
Jadi Machine Learning bukanlah:
assumption-free learning.
Perbedaannya adalah banyak metode ML menggunakan model yang lebih fleksibel dan lebih sedikit bergantung pada bentuk parametrik sederhana yang ditentukan sebelumnya.
Fleksibilitas tersebut membawa keuntungan.
Tetapi ada harga yang harus dibayar:
semakin fleksibel model → semakin besar potensi overfitting.
7. Bias–Variance Trade-Off
Konsep ini merupakan salah satu jembatan penting antara statistik dan Machine Learning.
Bayangkan model yang sangat sederhana.
Misalnya kita memaksakan hubungan linear padahal hubungan sebenarnya sangat kompleks.
Model dapat mengalami:
high bias.
Ia terlalu sederhana untuk menangkap pola.
Kondisi ini sering disebut:
underfitting.
Sebaliknya, model yang sangat kompleks dapat mengikuti hampir seluruh detail training data.
Termasuk noise.
Model tersebut dapat mengalami:
high variance.
Ia bekerja sangat baik pada training data tetapi buruk pada data baru.
Kondisi ini disebut:
overfitting.
Tujuan modelling adalah mencari keseimbangan:
Model terlalu sederhana
← Optimal Complexity →
Model terlalu kompleks
Konsep bias–variance trade-off merupakan salah satu fondasi statistical learning yang dibahas secara luas dalam literatur Hastie, Tibshirani, Friedman serta James dan kolega [4,5].
8. Breiman dan “The Two Cultures”
Salah satu artikel paling terkenal mengenai perbedaan tradisi statistik dan algorithmic modeling ditulis oleh Leo Breiman pada tahun 2001:
“Statistical Modeling: The Two Cultures.”
Breiman menggambarkan dua budaya dalam pemodelan data.
Data Modeling Culture
Diasumsikan bahwa data dihasilkan melalui model stokastik tertentu.
Secara sederhana:
X → Statistical Model → Y
Kita mencoba memahami struktur model tersebut.
Algorithmic Modeling Culture
Mekanisme yang menghasilkan data dapat dianggap tidak diketahui.
Fokusnya adalah menemukan suatu fungsi yang menghasilkan prediction sebaik mungkin:
X → Unknown Process → Y
↓
Algorithm attempts to predict Y
Breiman berargumen bahwa ilmu statistik seharusnya tidak hanya bergantung pada satu budaya pemodelan, tetapi memanfaatkan pendekatan yang lebih luas untuk menyelesaikan masalah berbasis data [1].
Artikel tersebut kemudian menjadi salah satu tulisan klasik dalam diskusi mengenai hubungan statistik modern dan Machine Learning.
9. Prediction Tidak Sama dengan Explanation
Misalnya sebuah model menemukan bahwa variabel:
jumlah kunjungan pelayanan kesehatan
merupakan predictor yang sangat kuat untuk penyakit kronis.
Model mungkin memiliki prediction yang sangat baik.
Tetapi apakah:
lebih sering datang ke fasilitas kesehatan menyebabkan penyakit kronis?
Tentu belum tentu.
Bisa saja orang yang sudah memiliki masalah kesehatan lebih sering datang ke pelayanan kesehatan.
Artinya:
Predictive Association ≠ Causal Relationship
Inilah alasan mengapa prediction dan causal inference harus dibedakan.
Shmueli menekankan bahwa explanatory power dan predictive power bukan hal yang identik. Sebuah model yang sangat berguna untuk memahami hubungan teoretis tidak otomatis merupakan predictor terbaik, begitu pula sebaliknya [2].
10. Contoh dalam Kesehatan Masyarakat
Mari kita lihat perbedaannya menggunakan masalah hipertensi.
Pertanyaan A
Faktor apa yang berhubungan dengan hipertensi pada penduduk dewasa Indonesia?
Pendekatan dapat berupa:
Statistical / Epidemiological Modeling
Outcome:
Hipertensi
Predictor:
umur + gender + IMT + pendidikan + merokok + aktivitas fisik
Hasil:
Adjusted Odds Ratio
95% Confidence Interval
p-value
Tujuan:
Inference / explanation
Pertanyaan B
Bisakah kita mengidentifikasi individu yang memiliki kemungkinan tinggi mengalami hipertensi?
Pendekatan dapat berupa:
Predictive Machine Learning
Dataset:
umur + gender + IMT + pendidikan + merokok + aktivitas fisik + pulse + berbagai predictor lainnya
Kemudian dibandingkan:
Logistic Regression
vs
Random Forest
vs
Support Vector Machine
vs
Gradient Boosting
vs
Neural Network
Hasilnya mungkin:
| Model | AUC |
|---|---|
| Logistic Regression | 0,79 |
| Random Forest | 0,81 |
| Gradient Boosting | 0,83 |
| Neural Network | 0,82 |
Tujuannya bukan mencari model dengan p-value terbanyak.
Tujuannya adalah:
model mana yang paling baik memprediksi outcome pada data yang belum pernah dilihat?
Tentu AUC juga bukan satu-satunya ukuran yang harus digunakan. Sensitivity, specificity, calibration, clinical/public-health utility, serta external validation tetap perlu dipertimbangkan.
11. Apakah Model yang Lebih Kompleks Selalu Lebih Baik?
Tidak.
Ini merupakan salah satu kesalahpahaman paling umum mengenai Machine Learning.
Ada kecenderungan menganggap:
Linear Regression
↓
Logistic Regression
↓
Decision Tree
↓
Random Forest
↓
Neural Network
↓
Deep Learning
sebagai urutan dari “kurang canggih” menuju “lebih baik”.
Padahal tidak demikian.
Model yang paling kompleks belum tentu memberikan prediction terbaik.
Dalam dataset tabular dengan jumlah observation terbatas, model yang relatif sederhana dapat mempunyai performa yang sama atau bahkan lebih baik.
Lebih jauh lagi, terdapat aspek lain yang harus dipertimbangkan:
- interpretability,
- computational cost,
- reproducibility,
- robustness,
- calibration,
- external validity,
- kemudahan implementasi.
Jika Logistic Regression menghasilkan:
AUC = 0,82
dan Neural Network:
AUC = 0,823
maka peningkatan performance yang sangat kecil mungkin tidak cukup untuk membenarkan hilangnya interpretabilitas dan meningkatnya kompleksitas implementasi.
Model terbaik adalah model yang:
sesuai dengan pertanyaan dan tujuan penggunaannya.
12. Statistik vs Machine Learning: Bukan Kompetisi
Cara yang lebih produktif adalah melihat keduanya sebagai sebuah spektrum.
Statistical Inference
lebih banyak menekankan:
Population → Sample → Model → Inference about Population
sementara predictive Machine Learning menekankan:
Past Data → Model → New Data → Prediction
Di tengah-tengah keduanya terdapat:
Statistical Learning
yang menggabungkan konsep statistik, komputasi, optimization, prediction, dan model evaluation.
Karena itu tidak mengherankan jika buku seperti An Introduction to Statistical Learning membahas dalam satu rangkaian:
- linear regression,
- logistic regression,
- resampling,
- regularization,
- trees,
- support vector machines,
- deep learning,
- survival analysis,
- clustering.
Hal tersebut menunjukkan bahwa batas antara statistics dan Machine Learning memang tidak kaku.
13. Kapan Menggunakan Statistik, Kapan Menggunakan Machine Learning?
Jawabannya bergantung pada pertanyaan.
Jika pertanyaan Anda:
Apakah X berhubungan dengan Y?
maka fokusnya cenderung:
statistical inference.
Jika pertanyaannya:
Berapa besar hubungan X terhadap Y?
fokusnya:
effect estimation.
Jika pertanyaannya:
Apakah intervensi X menyebabkan perubahan Y?
maka yang diperlukan:
causal inference dan desain penelitian yang mendukung identifikasi efek kausal.
Jika pertanyaannya:
Siapa yang kemungkinan akan mengalami Y?
fokusnya:
prediction.
Machine Learning dapat menjadi pendekatan yang sangat relevan.
Jika pertanyaannya:
Apakah terdapat kelompok alami dalam data?
kita dapat menggunakan:
unsupervised learning / clustering.
Jadi sebaiknya jangan memulai analisis dengan:
“Saya ingin menggunakan Random Forest.”
Tetapi mulai dengan:
“Apa pertanyaan yang sebenarnya ingin saya jawab?”
Baru kemudian menentukan metode yang sesuai.
14. Perspektif Epidemiologi: Association, Causation, dan Prediction
Untuk peneliti kesehatan masyarakat, mungkin bermanfaat membedakan tiga tujuan besar:
Association
Apakah X berkaitan dengan Y?
Contoh:
Apakah obesitas berhubungan dengan hipertensi?
Causation
Apakah perubahan X menyebabkan perubahan Y?
Contoh:
Apakah penurunan berat badan menyebabkan penurunan risiko hipertensi?
Prediction
Dapatkah X membantu memperkirakan Y pada individu yang belum diketahui outcome-nya?
Contoh:
Berdasarkan usia, IMT, aktivitas fisik, dan karakteristik lainnya, berapa probabilitas seseorang mengalami hipertensi?
Ketiganya dapat menggunakan data yang sama.
Bahkan sebagian metode matematisnya dapat sama.
Tetapi pertanyaan ilmiahnya berbeda.
Karena itu cara membangun dan mengevaluasi model juga harus berbeda.
15. Dari p-Value Menuju Predictive Performance
Perubahan perspektif dari statistik inferensial menuju Machine Learning juga membawa perubahan cara membaca hasil.
Dalam penelitian epidemiologi kita terbiasa melihat:
p < 0,05
OR = 1,53
95% CI = 1,30–1,81
Dalam predictive modeling kita mulai melihat:
AUC = 0,82
Sensitivity = 85%
Specificity = 73%
F1-score = 0,78
Brier Score = …
Calibration slope = …
Tidak berarti ukuran yang satu lebih “ilmiah” daripada yang lain.
Mereka menjawab pertanyaan yang berbeda.
Confidence interval membantu kita memahami uncertainty dalam estimasi parameter.
Sedangkan AUC, sensitivity, specificity, dan calibration membantu kita mengevaluasi kemampuan prediksi model.
16. Titik Pertemuan: Statistical Learning
Dikotomi statistik versus Machine Learning pada akhirnya mulai kehilangan makna ketika kita memasuki bidang:
Statistical Learning
Statistical Learning memanfaatkan:
Statistical Theory
Mathematics
Computer Science
Optimization
Algorithms
Data
untuk memahami dan memprediksi fenomena.
Karena itu para peneliti modern tidak harus memilih:
“Saya orang statistik.”
atau:
“Saya orang Machine Learning.”
Yang jauh lebih penting adalah mempunyai kemampuan untuk menentukan:
- pertanyaan penelitian,
- struktur data,
- target analisis,
- metode yang sesuai,
- cara validasi,
- cara interpretasi,
- dan batas penggunaan hasil.
Kesimpulan
Machine Learning dan statistik bukan dua pendekatan yang sepenuhnya terpisah.
Keduanya menggunakan data untuk memahami pola dan membangun model.
Perbedaannya terutama terdapat pada orientasi dan workflow.
Statistical inference secara tradisional banyak berfokus pada:
Estimation → Uncertainty → Inference → Explanation
Sedangkan Machine Learning banyak berfokus pada:
Training → Validation → Prediction → Generalization
Namun batas tersebut tidak absolut.
Statistik dapat digunakan untuk prediction.
Machine Learning dapat membantu memahami struktur data.
Logistic Regression dapat menjadi metode statistik sekaligus Machine Learning.
Dan berbagai metode modern berada dalam wilayah yang disebut:
Statistical Learning.
Karena itu pertanyaan terpenting sebelum melakukan analisis bukan:
“Haruskah saya menggunakan statistik atau Machine Learning?”
melainkan:
“Apa sebenarnya pertanyaan yang ingin saya jawab?”
Apakah kita ingin mengetahui:
hubungan?
efek?
penyebab?
atau:
membuat prediksi?
Jawaban terhadap pertanyaan tersebut akan menentukan bagaimana data dianalisis, bagaimana model dibangun, dan bagaimana hasilnya harus dievaluasi.
Dan dari sinilah kita sampai pada persoalan berikutnya.
Jika tujuan utama Machine Learning adalah melakukan prediksi pada data baru: Bagaimana kita memastikan bahwa model tidak sekadar menghafal data?
Referensi
- Breiman L. Statistical Modeling: The Two Cultures. Statistical Science. 2001;16(3):199–231. doi:10.1214/ss/1009213726.
- Shmueli G. To Explain or to Predict? Statistical Science. 2010;25(3):289–310. doi:10.1214/10-STS330.
- Bzdok D, Altman N, Krzywinski M. Statistics versus machine learning. Nature Methods. 2018;15(4):233–234. doi:10.1038/nmeth.4642.
- Hastie T, Tibshirani R, Friedman J. The Elements of Statistical Learning: Data Mining, Inference, and Prediction. 2nd ed. New York: Springer; 2009. doi:10.1007/978-0-387-84858-7.
- James G, Witten D, Hastie T, Tibshirani R. An Introduction to Statistical Learning: with Applications in R. 2nd ed. New York: Springer; 2021. doi:10.1007/978-1-0716-1418-1.