Pada artikel sebelumnya kita membahas bahwa salah satu orientasi utama Machine Learning adalah prediction: membangun model dari data yang tersedia agar mampu memberikan prediksi yang baik pada data baru.
Namun muncul pertanyaan penting:
Bagaimana kita mengetahui bahwa model benar-benar mampu memprediksi data baru, dan bukan sekadar menghafal data yang digunakan untuk membangunnya?
Di sinilah konsep training, validation, testing, dan cross-validation menjadi sangat penting.
Secara sederhana, prinsipnya adalah:
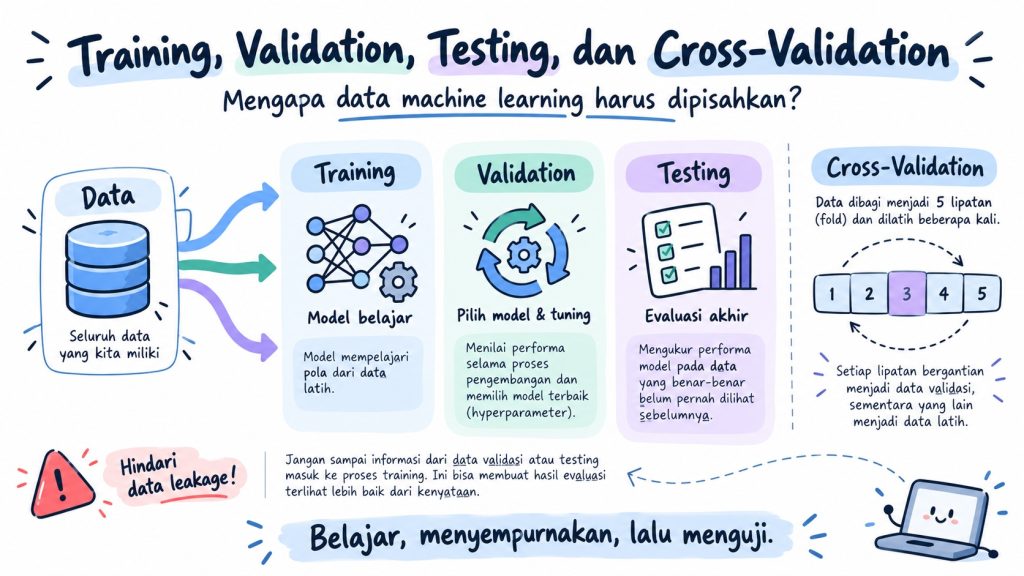
Model belajar dari satu bagian data, tetapi harus diuji menggunakan data yang tidak digunakan untuk belajar.
Mengapa Tidak Menggunakan Seluruh Data Sekaligus?
Bayangkan kita mempunyai data 10.000 orang untuk mengembangkan model prediksi hipertensi.
Variabel yang tersedia antara lain:
- umur,
- jenis kelamin,
- indeks massa tubuh,
- aktivitas fisik,
- status merokok,
- denyut nadi,
- dan status hipertensi.
Kita kemudian menggunakan seluruh 10.000 data tersebut untuk membangun model.
Setelah model selesai, kita mengevaluasinya menggunakan 10.000 orang yang sama.
Hasilnya:
Accuracy = 95%
Apakah berarti model kita sangat bagus?
Belum tentu.
Model sudah pernah melihat seluruh data tersebut selama proses pembelajaran. Karena itu, performa yang tinggi dapat mencerminkan kemampuan model menyesuaikan diri terhadap data yang sudah diketahui, bukan kemampuannya menghadapi data baru.
Situasi ini dapat dianalogikan dengan seorang mahasiswa yang diuji menggunakan soal yang persis sama dengan soal yang sudah diberikan beserta jawabannya saat belajar.
Yang ingin kita ukur sebenarnya adalah:
Apakah ia tetap dapat menjawab ketika diberikan soal yang belum pernah dilihat sebelumnya?
Dalam Machine Learning, prinsip ini disebut generalization.
Training Data: Tempat Model Belajar
Bagian pertama adalah training set.
Training data digunakan untuk membangun model.
Misalnya:
10.000 observation –> 8.000 Training Data –> Machine Learning Algorithm –> Trained Model
Pada tahap inilah algoritma mempelajari hubungan antara features dengan target.
Sebagai contoh:
Age + BMI + Smoking + Physical Activity + Pulse –> Training –> Prediction Model for Hypertension
Model dapat menyesuaikan parameter, memilih pola, atau membentuk struktur berdasarkan algoritma yang digunakan.
Karena itu:
Training data adalah data yang boleh “dilihat” oleh model ketika belajar.
Testing Data: Ujian Akhir untuk Model
Sebagian data kemudian disimpan sebagai test set.
Misalnya:
80% Training
20% Testing
Test data tidak digunakan untuk membangun model.
Setelah proses training selesai:
Trained Model –> Testing Data yang belum pernah dilihat –> Prediction –> Compare Prediction vs Actual Outcome
Dari sini kita dapat menghitung berbagai ukuran performance seperti:
- accuracy,
- sensitivity,
- specificity,
- precision,
- recall,
- F1-score,
- ROC-AUC,
- dan calibration.
TRIPOD+AI, pedoman terbaru untuk pelaporan model prediksi menggunakan regression maupun Machine Learning, menekankan pentingnya evaluasi performa model, termasuk discrimination, calibration, dan clinical utility. [3]
Dengan demikian, test data mempunyai fungsi yang sangat spesifik:
memberikan gambaran yang lebih objektif mengenai bagaimana model bekerja pada data yang tidak digunakan untuk mengembangkannya.
Lalu, Apa Fungsi Validation Data?
Persoalannya, selama membangun model kita sering harus membuat banyak keputusan.
Misalnya:
Random Forest
Berapa jumlah trees?
Decision Tree
Berapa maksimum kedalamannya?
k-Nearest Neighbors
Berapa nilai k?
Neural Network
Berapa layer dan neuron yang digunakan?
Pilihan seperti ini disebut hyperparameters.
Jika kita terus mencoba berbagai konfigurasi dan memilih model berdasarkan performance pada test data, maka secara tidak langsung test data telah ikut digunakan dalam proses pengembangan.
Test set tidak lagi benar-benar independen.
Karena itu kita dapat menambahkan:
validation set.
Workflow-nya menjadi:
Training Data = untuk membangun model
Validation Data = untuk memilih model dan hyperparameter
Testing Data = untuk evaluasi akhir
Mengapa Cross-Validation Dibutuhkan?
Membagi dataset sekali saja mempunyai kelemahan.
Misalnya kita melakukan:
80% training
dan
20% validation
Bagaimana jika secara kebetulan validation set berisi kelompok yang lebih mudah atau lebih sulit diprediksi?
Hasil evaluasi dapat berubah hanya karena pembagian data.
Salah satu pendekatan yang umum digunakan untuk mengurangi masalah tersebut adalah:
Cross-Validation
Metode yang sangat populer adalah k-fold cross-validation.
Misalnya:
5-Fold Cross-Validation
Data dibagi menjadi lima bagian:
Fold 1 | Fold 2 | Fold 3 | Fold 4 | Fold 5
Pada putaran pertama:
Fold 1 = Validation
Fold 2–5 = Training
Putaran kedua:
Fold 2 = Validation
Fold 1, 3, 4, 5 = Training
Proses tersebut dilanjutkan sampai seluruh fold pernah menjadi validation data.
Akhirnya kita memperoleh lima hasil performance yang kemudian dapat diringkas, misalnya menggunakan rata-rata.
Cross-validation merupakan salah satu metode penting dalam model assessment dan model selection dan dibahas secara fundamental dalam literatur statistical learning. [1,2]
Contoh Sederhana
Misalnya kita ingin membandingkan tiga model prediksi hipertensi:
Logistic Regression
Random Forest
Support Vector Machine
Dengan 5-fold cross-validation kita memperoleh:
| Model | Mean AUC |
|---|---|
| Logistic Regression | 0,79 |
| Random Forest | 0,82 |
| Support Vector Machine | 0,80 |
Hasil ini dapat membantu kita memilih model dan melakukan tuning.
Setelah seluruh proses pengembangan selesai, model yang dipilih kemudian dievaluasi sekali lagi menggunakan test set yang sejak awal disimpan terpisah.
Konsepnya menjadi:
Development Data
→ Training
→ Cross-Validation
→ Hyperparameter Tuning
→ Model Selection
kemudian:
Independent Test Data
→ Final Evaluation
Jangan Sampai Terjadi Data Leakage
Memisahkan training dan testing belum cukup jika proses pengolahan datanya salah.
Salah satu masalah yang sangat penting dalam Machine Learning adalah:
Data Leakage
Data leakage terjadi ketika informasi dari validation atau test data secara tidak sengaja masuk ke dalam proses training.
Contoh sederhana adalah melakukan standardisasi menggunakan:
mean dan standard deviation seluruh dataset
sebelum data dibagi menjadi training dan testing.
Model secara tidak langsung telah memperoleh informasi dari test data.
Workflow yang lebih tepat adalah:
Split Data — > Training Data
- Hitung mean, SD, imputasi, feature selection, dan preprocessing lainnya
- Terapkan parameter tersebut pada validation/test data.
Prinsip dasarnya:
Informasi dari masa depan atau dari test set tidak boleh digunakan untuk membantu model belajar.
Masalah Khusus pada Data Kesehatan
Dalam data kesehatan, pemisahan data membutuhkan perhatian tambahan.
Misalnya satu pasien mempunyai 10 kali kunjungan.
Jika lima kunjungan masuk training dan lima kunjungan lainnya masuk testing, sebenarnya model sudah pernah “melihat” pasien yang sama.
Performance model dapat terlihat lebih tinggi daripada kemampuan sebenarnya ketika menghadapi pasien baru.
Dalam kondisi seperti ini, splitting sebaiknya dilakukan pada:
patient level
bukan sekadar:
row level.
Prinsip yang sama berlaku pada data longitudinal, rumah sakit, fasilitas kesehatan, atau wilayah.
Kadang evaluasi yang lebih realistis justru menggunakan:
temporal validation
misalnya model dibangun menggunakan data 2020–2024 dan diuji pada data 2025,
atau:
geographical/external validation
misalnya model dibangun menggunakan data Jakarta dan diuji pada populasi Jawa Barat.
Internal Evaluation vs External Evaluation
Ada perbedaan penting antara mengevaluasi model menggunakan data dari sumber yang sama dengan mengevaluasinya pada populasi yang benar-benar berbeda.
Internal Evaluation
Misalnya:
Cross-validation
Bootstrapping
atau pemisahan development/test dari dataset yang sama.
Tujuannya mengetahui seberapa stabil model dalam data pengembangan.
TRIPOD+AI memasukkan train-test split, cross-validation, dan bootstrapping sebagai pendekatan untuk internal validation/evaluation model prediksi. [3]
External Evaluation
Model diuji pada:
- rumah sakit berbeda,
- daerah berbeda,
- periode waktu berbeda,
- atau populasi berbeda.
External evaluation memberikan pertanyaan yang lebih sulit:
Apakah model masih bekerja ketika keluar dari lingkungan tempat ia dikembangkan?
Untuk model kesehatan yang akan digunakan secara luas, pertanyaan ini sangat penting.
Apakah Semakin Banyak Training Data Selalu Lebih Baik?
Secara umum, model memang memperoleh manfaat dari lebih banyak data training. Namun bukan berarti kita harus memasukkan seluruh data ke training set dan menghilangkan evaluasi independen. Kita tetap membutuhkan mekanisme untuk mengetahui apakah model mampu melakukan generalisasi.
Pada dataset yang relatif kecil, pembagian train-validation-test secara sederhana bahkan dapat membuang banyak informasi. Karena itu cross-validation atau bootstrapping sering menjadi pendekatan yang lebih efisien untuk internal evaluation.
Pemilihan strategi harus mempertimbangkan:
- jumlah data,
- prevalensi outcome,
- struktur longitudinal,
- clustering,
- tujuan prediction,
- dan populasi target.
Tidak ada satu rasio seperti 80:20 atau 70:30 yang otomatis selalu benar untuk semua penelitian.
Referensi
- Hastie T, Tibshirani R, Friedman J. The Elements of Statistical Learning: Data Mining, Inference, and Prediction. 2nd ed. New York: Springer; 2009. doi:10.1007/978-0-387-84858-7.
- James G, Witten D, Hastie T, Tibshirani R. An Introduction to Statistical Learning: with Applications in R. 2nd ed. New York: Springer; 2021. doi:10.1007/978-1-0716-1418-1.
- Collins GS, Moons KGM, Dhiman P, et al. TRIPOD+AI statement: updated guidance for reporting clinical prediction models that use regression or machine learning methods. BMJ. 2024;385. doi:10.1136/bmj-2023-078378.